Appearance
从零学transformer
encoding和decoding
在hugging face中,有对transformer的入门介绍:https://huggingface.co/learn/llm-course/zh-CN/chapter1/4
个人理解中,encoding模型将语句映射为高维空间,比如分类;decoding模型可以把语句在当前维度空间中进行扩展,比如续写。
还有encoding-decoding模型,结合了两者的特性,应用为翻译,问答这种场景。
embedding
虽然中文的翻译是词嵌入,但是挺不知所云的。embedding可以理解为将人能看懂的词,转换为机器能看懂的向量。毕竟机器只能处理数字。
self attention
如果抛弃一些AI相关的知识,一个句子由多个词组成,每个词都有自己的含义。但是词和词的组合是有某种联系的,一个段子是“要断章取义”,取自《不要断章取义》。
再引入一些基本的AI知识,词不是模型处理的基本单元,token才是。token和token之间的逻辑关系,就是attention来解决的问题。
在已经简单理解embeding后,用什么方法来建立向量和向量之间的逻辑关系?需要抽象出来另外几个向量,毕竟向量只能和向量进行计算。这里出现的就是Q,K,V向量。
那么什么是Q,K,V向量?
Q, query,查询向量。 K, key,键向量。 V, value,值向量。
attention如何计算呢?根据第一性原理,如果要计算一个词的attention,肯定要和这个词的所有其他词进行计算,这样才能知道这个词和其它词之间的联系。虽然思路是这样,但是实现上另有独到之处。
第一步,每个输入的词向量都会计算出对应的Q,K,V向量。计算方法是将词向量分别与权重矩阵WQ,WK,WV进行矩阵乘法。WQ, WK, WV是训练过程中学习到的参数。
第二步,就可以计算self attention了。将一个词的查询向量q和包括它自身的所有k向量进行点积,可以得到一系列表示相关性的值。相关性越高,值越大。那么显然,一个词和它自身的相关性最高,所以点积值也最高。(但实际上这不是所期望的,有其它方法可以避免词只关注它自身。)
第三步和第四步,可以认为是归一化的过程。这里再引入一点知识,softmax函数,可以将一系列表示相关性的值,转换为一个概率分布。
第五步,将每个值向量v,乘以上面得到的softmax的概率分布。
第六步,将第五步的加权后的向量相加,就得到了这个词的attention向量z。这个z就可以交给feed forward层了。
矩阵化attention计算
一个词的attention计算是上面的流程,但是真算的时候不会这么串行算的。 将所有的词向量打包成矩阵X(X的每一行是一个词向量),分别与权重矩阵WQ,WK,WV进行矩阵乘法,就可以得到所有的词的Q,K,V向量。
将步骤二到六合并为一个公式,softmax(Q × K^T / √d_k)V = Z
multi attention
根据上文,注意力和k和q点积大小相关,这种计算方法下,一个词肯定和它自身最相关。但是,对于“小明太累了,他想休息”这个句子,“他”如何和“他”最相关显然对于理解语义是没作用的。应该让“他”注意到“小明”上。
上文中,只有一组WQ,WK,WV。只能表示一个维度的“注意力”。大模型很难有解释性,这个维度可能表示时间,空间,情感,语法或任意什么维度的一种,那么最终得到的注意力可能不那么准确。引入多头后,就有多组WQ,WK,WV(文中说transformer有8个注意力头),所以最终会得到8个Z矩阵。
在学习的时候,和transformer layer的是有容易混淆的地方的。transformer的layer同样也是在某个维度上对输入进行处理。浅层的layer会处理语法结构,到深层的layer会处理更复杂的语义关系。多头注意力也是在多个维度上对输入进行处理。看起来和layer的功能是有重叠的。它们的区别是,layer是链接的,一层layer处理后的信息会作为下一层layer的输入,是一个信息递进的深度处理的过程。多头的信息处理是并行的,头之间是没有关联的。结构上,layer是包含MHA的(也可以说MHA是transformer layer的一个子模块)。
但是feed forward层只接收一个Z矩阵,所以需要将8个Z矩阵变成一个。
文中的方法是,将8个Z矩阵拼接起来,然后再乘以一个额外的权重矩阵W_O,得到的一个最终的Z。
position encoding
在矩阵化attention计算中,流程如下:
- 将所有的词向量打包成了矩阵X
- 将X分别与权重矩阵WQ,WK,WV进行矩阵乘法,得到Q,K,V
- Q和K_T进行点积,得到一系列表示相关性的值,然后使用softmax归一化
- 上一步得到的矩阵乘以V,得到最终的Z矩阵
- 多头合并,然后传递给feed forward层
从上面步骤中,矩阵乘来乘去,虽然词向量已经被变换了数次,但是都是并行计算的,也就是传递给模型的“我爱你”和“你爱我”再模型的视角下是一个东西。如何保留并行计算的高效率,并且还要保留语序的信息?
解决办法是在词向量中引入位置相关的信息,那么在后续的注意力中,位置也会成为一个维度信息被考虑。当然,位置编码也是一个深入的话题,这里不再展开。
residuals
残差实际上是一个数学问题。大模型的训练简单来说就是在找一个函数的参数,使得函数的输出和目标之间的差最小。寻找这些参数的方法是梯度下降,梯度下降通过链式法则计算,如果每一层的偏导数都很小,最终的梯度就会被计算成0了,毕竟计算机只能处理有限的精度,这时就出现了梯度消失。避免梯度消失的方法就是残差。transformer中每一个子层后都会跟一个残差链接(进行ADD & Norm操作)。
decoder side
上面的内容涵盖了encoder的大部分内容。encoder处理输入序列后,会得到一组注意力向量K和V。每个decoder在attention层中都会使用这些注意力向量。最后经过linear和softmax后,输出内容。
后续步骤会重复这个过程,直到decoder输出完毕。解码器中也会嵌入位置编码,来保留语序的信息。
解码器的attention层和编码器行为不同,解码器只能关注输出序列中较早的位置,这个行为就像你不能用测试集来训练模型一样。
linear and softmax layer
解码器最终给出的还是一个浮点向量,最后一步是“翻译”成人话了。
linear 层是一个全连接层,将解码器的输出向量映射到一个高维空间,称为logits向量。如果模型学会了1000个词,那么logits向量的维度就是1000。softmax层会将logits向量转换为一个概率分布,每个元素表示对应词的概率。最后,将概率分布中的最大值对应的词作为模型的输出。
补充:论文原文相关知识点
根据李沐老师的论文精读视频,补充一些知识点。
论文中的transformer架构图在看懂之后还是比较简单的。
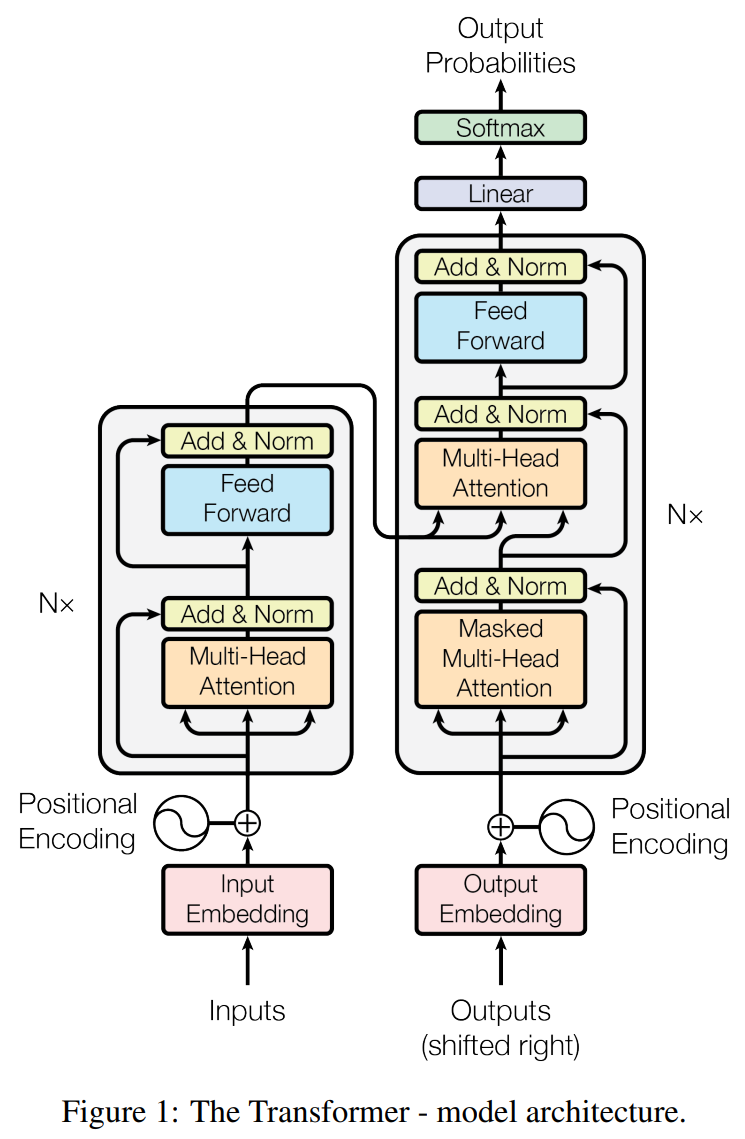
原文中应用的是一个翻译场景,该场景下,需要decoder和encoder模块同时使用。
之前一直没太理解这两个模块,实际上,这两个模块不太严谨的说都是由attention layer和MLP组成的。
从架构图中,左侧的是encoder模块,原文中的N=6,也就是说encoder模块重复了6层。encoder模块由两个sub layer组成:multi-head attention layer和MLP。MHA的输入是 来源于同一个序列的 QKV,attention的输出是和输入维度一致的,包含完整序列信息的向量。attention后跟了残差链接和layerNorm,目的是为了避免梯度消失和获取稳定的特征分布。
MLP层起的是提取特征的作用。经过attention后,虽然输出已经包含了序列的所有信息,但是具体需要的是什么还是需要MLP来提取的。MLP层后仍然跟着残差链接和layerNorm。得到的结果送入下一层继续处理。
理解左侧的encoder模块后,可以发现右侧的decoder模块基本是在encoder模块上做了少许的改动。首先,decoder模块的sublayer中多了一个masked multi-head attention layer。然后它同样有和encoder模块一样的multi-head attention layer和MLP层。
masked multi-head attention layer 多了一个mask矩阵,用于屏蔽未来的位置。这是为了避免在预测下一个词时,模型能够“ cheat” 并使用未来的信息。
decoder的MHA有稍许不同,它的输入的K,V来自于encoder的输出,Q才是decoder自身序列的查询向量。它的意义是,一个序列可以在另一个序列中查询相关性映射,这就是翻译场景。
这里我灵光一闪,像GPT这种纯对话的decoder模型,显然是不需要这种cross-attention的。简单搜索后,GPT确实decoder模块中只有masked multi-head attention layer和MLP层。